
Exécutez Qwen TTS3 localement - Générateur vocal AI hors ligne


Découvrez comment configurer Qwen TTS3 localement sur votre PC
QWEN3-TTS est la dernière génération de modèles de synthèse vocale open source de l'équipe Qwen d'Alibaba Cloud, publiée en janvier 2026. Il est conçu pour une latence ultra-faible, une expressivité élevée et un contrôle flexible via le langage naturel.
Comment fonctionne QWEN3-TTS
Contrairement aux modèles traditionnels qui utilisent une étape de diffusion distincte, QWEN3-TTS traite la synthèse vocale comme une tâche de modélisation du langage, de la même manière que les modèles textuels prédisent le mot suivant.
- Architecture à deux voies : Il utilise une architecture hybride à double piste qui prend en charge à la fois la génération en streaming et sans diffusion.
- Tokénisation vocale : Le système compresse le son en unités discrètes (jetons) à l'aide de deux tokeniseurs spécialisés :
- Tokéniseur de jetons 25 Hz : Capture une haute résolution temporelle et des détails acoustiques, en donnant la priorité à la qualité.
- Tokéniseur de jetons 12 Hz : Atteint une compression extrême et une latence ultra-faible, permettant une sortie audio immédiate « premier paquet ».
- Livre multicode LM discret : En modélisant les jetons vocaux directement dans une architecture de bout en bout, il contourne les goulots d'étranglement d'informations présents dans les anciens schémas « LM + Diffusion ».
Qu'est-ce qui le rend unique
Qwen3-TTS se distingue par son haut degré de contrôlabilité et sa rapidité sur du matériel grand public.
Configuration locale et open source (Promptus)
Vous pouvez exécuter Qwen3-TTS entièrement hors ligne à l'aide du Promptus application de bureau. Cela garantit la confidentialité de vos données audio et évite les frais de crédit par minute.
1. Configuration initiale
- Exigences : Une machine locale équipée d'un GPU NVIDIA (CUDA) est recommandée pour des raisons de vitesse, bien que le mode CPU soit également pris en charge (à des vitesses plus lentes).
- Ouvrez Promptus Manager : Dans l'application Promptus, accédez à Profil → Ouvrir le gestionnaire.
2. Installation du serveur et du flux de travail
- Serveur ComfyUI : Dans le gestionnaire, cliquez sur Installer → Serveur ComfyUI. Il s'agit de l'épine dorsale nécessaire pour exécuter les flux de travail locaux.
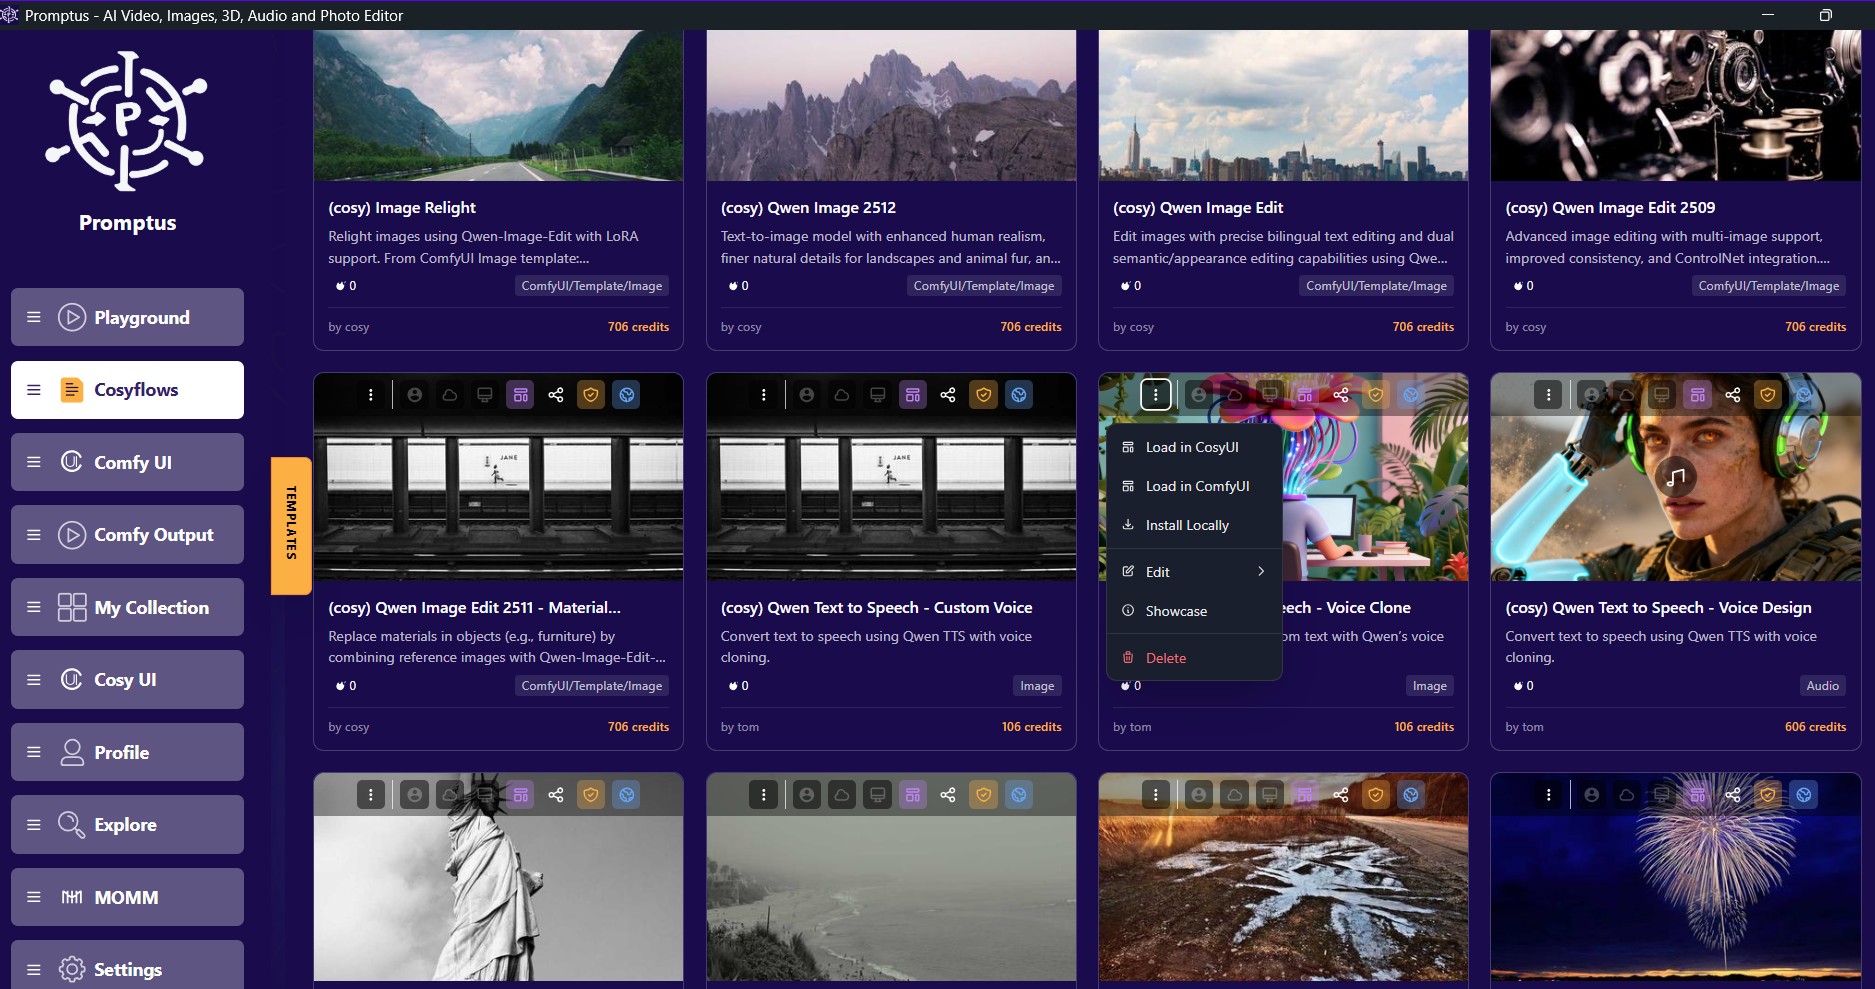
- Télécharger QWen3-TTS : Accédez au Flux de coûts section de l'application Promptus. Recherchez « Qwen » et sélectionnez QWEN3-TTS flux de travail (par exemple, voix personnalisée, clone vocal ou conception vocale) et cliquez sur Télécharger/Installer.
3. Exécuter hors ligne
- Workflow de lancement : Retournez à l'application principale Promptus et rendez-vous sur Flux de coûts onglet.
- Sélectionnez le mode d'exécution : Cliquez sur l'icône en haut à droite et choisissez Installation locale ou Exécuter hors ligne.
- Générez : Une fois le serveur local démarré, entrez votre texte et vos paramètres (langue, type de voix, etc.) et cliquez sur Générez.
Remarque : Lors de la première exécution, l'application téléchargera automatiquement les poids de modèle nécessaires (0,6 B ou 1,7 B) depuis Hugging Face.

Générateur de IA
Promptus AI est le moyen le plus simple de générer des photos réalistes grâce à l'intelligence artificielle.
Notre générateur de photos IA produit des portraits, des images de produits et des concepts créatifs réalistes en quelques secondes, ce qui en fait l'outil idéal pour les créateurs et les marques.
