

Générez le même personnage à travers des dizaines de scènes sans perdre son visage, sa tenue ou son style — découvrez le fonctionnement de la référence multi-images de FLUX2, accompagné d'un guide de configuration locale avec Promptus.
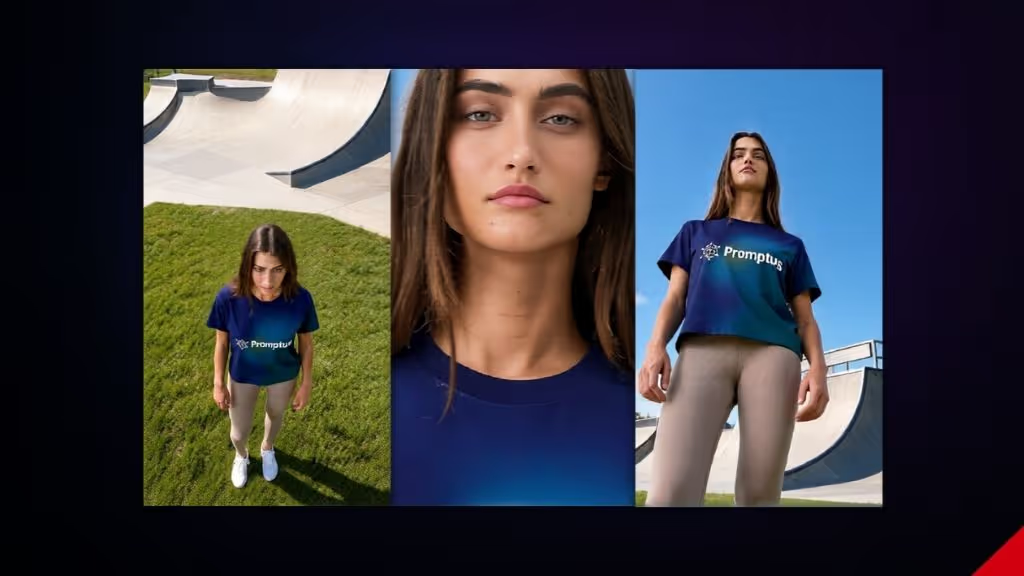
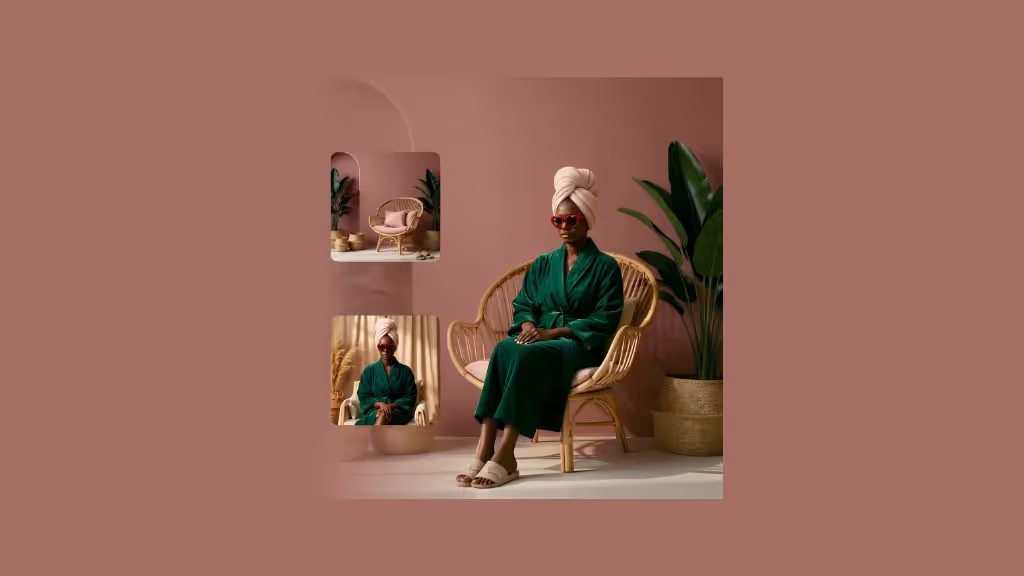
L'une des frustrations les plus tenaces de la génération d'images par IA est l'incohérence des personnages. Générez une même personne à travers dix scènes différentes et vous obtiendrez dix personnes légèrement distinctes — des mâchoires différentes, des couleurs de cheveux changeantes, des vêtements dépareillés. Le système de référence multi-images de FLUX2 change fondamentalement la donne en vous permettant d'injecter simultanément plusieurs photos d'un même sujet dans le processus de génération, ancrant ainsi l'identité visuelle à travers chaque création.
Ce guide explique le fonctionnement technique de ce mécanisme, la configuration requise pour l'exécuter sur votre propre GPU avec des outils comme Promptus, et comment obtenir des résultats cohérents dès votre première génération.
La référence multi-images FLUX2 est une technique de conditionnement qui injecte simultanément plusieurs photos d'un même sujet dans le processus de génération, fixant ainsi l'identité visuelle du résultat à travers différentes scènes, angles et conditions d'éclairage.
Contrairement au conditionnement à image unique (IP-Adapter), la référence multi-images offre au modèle une compréhension plus riche et multi-angle du sujet, réduisant considérablement la dérive d'identité entre les générations.
Elle s'exécute localement sur les GPU NVIDIA en utilisant la variante FLUX.2 Dev FP8 (environ 12 à 16 Go de VRAM), ou en pleine précision sur les cartes de 24 Go+. Aucun service cloud n'est requis.
Le problème de la cohérence des personnages dans la génération d'images par IA
Les modèles de diffusion génèrent des images en débruitant de manière itérative un bruit aléatoire — un processus intrinsèquement stochastique. Sans un conditionnement fort, chaque génération repart de zéro, c'est pourquoi vos personnages IA ont un aspect légèrement (ou radicalement) différent d'une image à l'autre.
La solution de contournement à référence unique — qui consiste à fournir une seule photo de votre personnage comme référence de style ou d'identité via IP-Adapter — aide, mais ne résout pas le problème. Une seule image n'offre au modèle qu'un seul angle, une seule condition d'éclairage, une seule expression. Le modèle extrapole le reste, et c'est dans cette extrapolation que s'immisce la dérive d'identité.
Ce problème est particulièrement contraignant pour :
- Les auteurs de bandes dessinées et de storyboards qui ont besoin du même protagoniste sur des dizaines de vignettes
- Les concepteurs de jeux vidéo qui créent des fiches de personnages et des concepts arts
- Les photographes de produits qui doivent intégrer un même produit dans des contextes de mise en situation variés
- Les producteurs de vidéos qui ont besoin d'une continuité visuelle d'une image à l'autre
Les approches précédentes impliquaient soit un entraînement de type LoRA (qui nécessite des heures d'apprentissage par personnage), soit l'utilisation d'IP-Adapter (qui fonctionne avec une seule référence et produit une cohérence limitée). La référence multi-images de FLUX2 répond directement à ces deux limites : elle est instantanée, ne requiert aucun entraînement et s'appuie simultanément sur plusieurs angles de vue de référence.
Qu'est-ce que la référence multi-images FLUX2 — et comment fonctionne-t-elle concrètement ?
La référence multi-images FLUX2 fonctionne en encodant plusieurs photos d'un même sujet et en injectant ces informations visuelles combinées dans les couches d'attention (attention layers) du modèle pendant la génération. Le modèle construit une représentation interne multi-angle plus riche du sujet avant même le rendu du premier pixel, ce qui réduit considérablement la dérive d'identité d'une scène à l'autre.
La base technique repose sur l'architecture hybride de FLUX.2, publiée par Black Forest Labs en novembre 2025. Contrairement à FLUX.1, qui utilisait deux encodeurs de texte distincts, FLUX.2 associe un modèle vision-langage Mistral-3 24B (VLM) à un transformeur à flux rectifié (rectified flow transformer). Le VLM traite simultanément les entrées textuelles et visuelles — y compris toutes les images de référence en même temps —, offrant ainsi une compréhension contextuelle calquée sur le monde réel. Le transformeur à flux rectifié gère ensuite les relations spatiales, les propriétés des matériaux et la logique de composition qui transforment cette compréhension en pixels calculés.
Parce que l'architecture de Mistral-3 est un véritable modèle vision-langage entraîné à grande échelle sur des données textuelles et visuelles entrelacées, il peut traiter nativement plusieurs images de référence — sans modules d'adaptation externes. Toutes les images de référence sont injectées dans le même pipeline d'attention multimode, traitées ensemble plutôt que de façon séquentielle. Il en résulte un signal de conditionnement qui encode le sujet sous plusieurs angles et éclairages simultanément, offrant au transformeur un « modèle mental » bien plus complet de l'apparence du sujet avant que la génération ne commence.
FLUX.2 prend en charge jusqu'à 10 images de référence pour une seule génération. Dans la pratique, la plage idéale pour garantir la cohérence d'un personnage se situe entre 4 et 6 images : en dessous de 3, le modèle manque d'informations sur les angles et la lumière ; au-dessus de 8, les références supplémentaires offrent un rendement décroissant et augmentent l'utilisation de la VRAM sans améliorer significativement la cohérence.
La force de référence (reference strength) contrôle le degré de fidélité du résultat à l'identité de référence par rapport aux indications du prompt de la scène. Une valeur de 0.7 est le point de départ recommandé pour la plupart des travaux de cohérence de personnage, avec une plage d'utilisation efficace comprise entre 0.6 et 0.8. En dessous de 0.5, la dérive d'identité réapparaît. Au-dessus de 0.9, la liberté de composition se retrouve réduite.
Référence multi-images FLUX2 vs FLUX Kontext — Quelle est la différence ?
Beaucoup d'utilisateurs qui recherchent la référence multi-images FLUX2 font en réalité allusion à FLUX Kontext, et il est facile de les confondre. Il s'agit pourtant d'outils différents conçus pour des tâches distinctes.
FLUX.1 Kontext (sorti plus tôt en 2025 par Black Forest Labs) est un modèle d'édition d'images sensible au contexte. Son cas d'usage principal consiste à effectuer des modifications précises et localisées sur des images existantes en utilisant le langage naturel — « changer la veste en rouge », « ajouter une tasse de café sur la table ». C'était le premier modèle FLUX à apporter une cohérence de personnage via l'édition contextuelle, mais il fonctionne à partir d'une seule image de référence et est optimisé pour la retouche plutôt que pour la génération à partir de zéro.
La référence multi-images FLUX2 est intégrée nativement dans les modèles FLUX.2 Dev et Pro. Elle est conçue pour générer de nouvelles images en préservant l'identité du sujet à travers plusieurs créations, et non pour éditer une image unique. La référence multi-images est l'outil idéal lorsque vous avez besoin du même personnage dans 12 scènes différentes ; Kontext est l'outil adapté lorsque vous devez modifier un élément précis sur une image existante.
| Référence multi-images FLUX2 | FLUX Kontext | |
|---|---|---|
| Modèle de base | FLUX.2 Dev / Pro / Flex | FLUX.1 Kontext |
| Architecture | Mistral-3 24B VLM + Rectified Flow | FLUX.1 Dev avec conditionnement contextuel | Oui (Dev ; Apache 2.0 pour Klein) | Oui (flux1-dev-kontext) |
| Configuration locale | Via Promptus ou ComfyUI | Via les fichiers safetensors kontext dans ComfyUI |
| Cas d'usage principal | Cohérence de personnage à travers de nouvelles générations | Édition sensible au contexte d'images existantes |
| Images de référence | Multiples (4 à 6 recommandées, jusqu'à 10) | Généralement une seule image |
| Taille du modèle | ~12 Go en FP8, ~64 Go en FP16 | ~12 Go (FP8 Scaled) |
Le fichier safetensors de Kontext mis à l'échelle en FP8 (flux1-dev-kontext_fp8_scaled.safetensors) est très téléchargé car il permet l'édition locale avec Kontext sur des GPU grand public — mais il n'offre pas la fonctionnalité de référence multi-images native de FLUX.2. Pour obtenir une cohérence de personnage multi-images, c'est FLUX.2 Dev qu'il vous faut, et non le modèle Kontext.
Comment utiliser localement la référence multi-images avec FLUX2 — Étape par étape
L'exécution de la référence multi-images FLUX2 dans Promptus ne nécessite pas de chercher des fichiers de modèles sur HuggingFace ni de placer des fichiers safetensors dans des dossiers spécifiques. Promptus gère automatiquement l'administration des modèles. Il existe trois façons de commencer :
Une fois que vous êtes dans le workflow, le processus se déroule ainsi :
-
Étape 1 : Préparez vos images de référence.
Visez 4 à 6 images du même sujet sous différents angles — de face, de trois quarts et de profil au minimum. Utilisez des conditions d'éclairage variées et au moins deux expressions différentes. Privilégiez des arrière-plans épurés ou simples ; les arrière-plans complexes réduisent la qualité du conditionnement du sujet.
-
Étape 2 : Téléversez vos références et réglez la force.
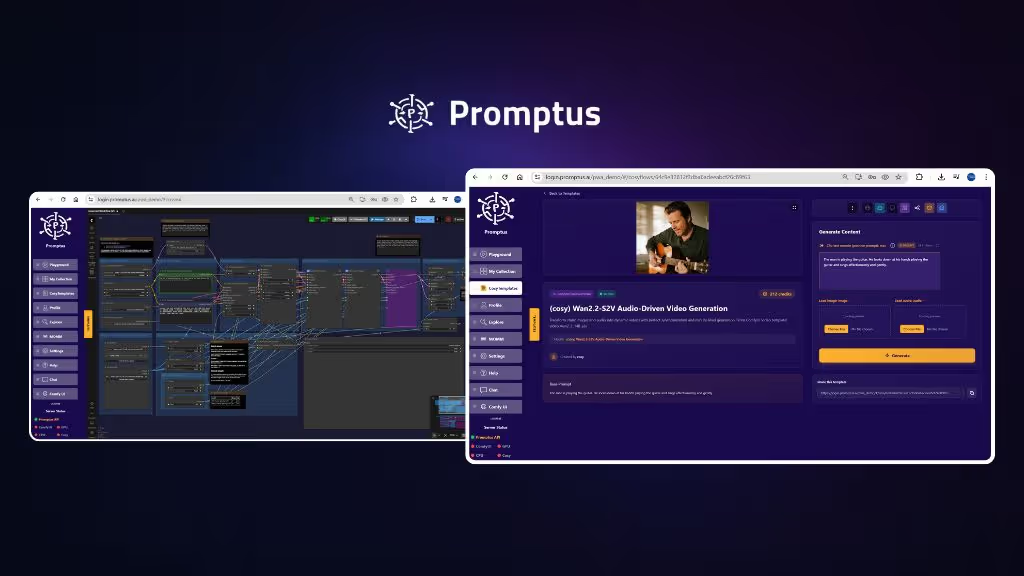
Promptus affiche les entrées d'images de référence et les commandes de force dans une interface visuelle simple. Définissez la force de référence sur 0.7 comme point de départ — la plage efficace se situe entre 0.6 et 0.8. Vous pouvez cibler les images par leur index numérique (image 1, image 2) ou par des descriptions en langage naturel.
-
Étape 3 : Rédigez un prompt axé sur la scène et générez.
Ne décrivez pas l'apparence du sujet — les références s'en chargent. Décrivez la scène, l'environnement, l'action, le style et l'éclairage : « assis dans un café, lumière dorée de l'après-midi, photoréaliste, objectif 85mm, faible profondeur de champ ». Si le personnage s'éloigne des références sur le résultat, augmentez la force vers 0.8. Si la composition semble trop figée sur les poses de référence, réduisez-la vers 0.6.
Obtenir les meilleurs résultats — Conseils pour les images de référence et formule de prompt idéale
La qualité de vos images de référence détermine le niveau maximal de cohérence que vous pourrez atteindre. Voici ce qui compte réellement :
Bonnes pratiques pour les images de référence
- La plage idéale se situe entre 4 et 6 images. En deçà de 3, le modèle manque d'informations sur les angles. Au-delà de 8, les gains sont dégressifs et l'utilisation de la VRAM augmente sans amélioration proportionnelle.
- Intégrez des angles variés. Le visage de face, de trois quarts et le profil sont un strict minimum. Le modèle construit sa compréhension de la forme tridimensionnelle du sujet à partir d'entrées en 2D — si des angles manquent, il va extrapoler, ce qui amorce la dérive.
- Variez les éclairages. Incluez au moins une image avec un éclairage neutre et une autre avec une lumière plus directionnelle. Sans cette diversité, le modèle risque d'assimiler une condition d'éclairage spécifique comme faisant partie intégrante de l'identité du personnage.
- Variez les expressions. Pour garantir la cohérence des traits du visage, incluez au moins deux expressions différentes. Un modèle conditionné sur des expressions identiques aura tendance à figer cette expression unique sur tous les résultats.
- Utilisez des arrière-plans épurés. Les références comportant des arrière-plans complexes empêchent le modèle d'isoler correctement le sujet. Des arrière-plans unis ou floutés améliorent considérablement la qualité du conditionnement.
- Une résolution minimale de 512×512, idéalement 1024×1024. Des références à basse résolution produisent une cohérence de moindre fidélité — le modèle dispose simplement de moins d'informations visuelles pour travailler.
La formule de prompt pour la référence multi-images
Le principe fondamental : les références gèrent le qui, les prompts gèrent le où, quand et comment.
- Ne décrivez pas l'apparence du sujet — c'est le rôle des images de référence
- Décrivez précisément la scène, l'environnement, l'action, l'éclairage, le style, l'angle de caméra et l'ambiance
- Une force de référence entre 0.6 et 0.8 constitue la plage de travail efficace. En dessous de 0.5, la dérive s'installe. Au-dessus de 0.9, la liberté de composition est restreinte
- Des modificateurs de poids de prompt comme
flux2devethigh fidelitypeuvent améliorer la rétention des traits du personnage
[scène/lieu], [éclairage], [action], [style], [caméra]
"debout sur le quai d'un métro, éclairage néon au plafond, regardant son téléphone, photographie de rue sur le vif, 35mm, photoréaliste"
Configuration matérielle requise pour exécuter FLUX2 localement
Étant donné que FLUX.2 intègre le modèle vision-langage Mistral-3 24B, les exigences en matière de mémoire vidéo (VRAM) sont plus élevées que pour les modèles de la génération précédente. Voici la configuration minimale et recommandée pour une exécution locale fluide :
| Configuration | VRAM Requise | Précision du Modèle | Résolution Maximale |
|---|---|---|---|
| Minimale | 12 Go VRAM | Quantifié (FP8 / INT8) | 1024×1024 |
| Recommandée | 16 Go - 24 Go VRAM | FP8 Natif / FP16 Partiel | 1536×1536 |
| Professionnelle | 24 Go+ VRAM (e.g., RTX 4090 / 5090) | Pleine précision (FP16) | 2048×2048+ |
Si vous manquez de mémoire avec une carte de 12 Go, activez l'option d'optimisation de la mémoire (Low VRAM mode) dans les paramètres de Promptus. Cela déchargera temporairement les couches du modèle de la VRAM vers la RAM système entre les étapes de traitement du VLM et du transformeur.
Dépannage des problèmes courants de cohérence
Le visage ou les traits du personnage changent d'une image à l'autre
Augmentez la force de référence par paliers de 0.05 (par exemple, passez de 0.7 à 0.75 ou 0.8). Vérifiez également vos images de référence : si elles manquent d'angles de profil ou de trois quarts, ajoutez de nouvelles photos pour combler les angles morts du modèle.
Le personnage garde la même pose ou la même expression sur toutes les générations
La force de référence est trop élevée (souvent supérieure à 0.85), ce qui pousse le modèle à copier littéralement l'une des images sources. Abaissez la force vers 0.65 ou 0.6 pour redonner de la liberté de composition au prompt de scène.
L'arrière-plan de la nouvelle image ressemble étrangement aux arrière-plans des photos de référence
Le modèle ne parvient pas à isoler le sujet. Utilisez des images de référence avec des arrière-plans neutres, blancs ou floutés à l'aide d'un effet bokeh (faible profondeur de champ). Vous pouvez également utiliser l'outil de détourage intégré dans Promptus pour supprimer l'arrière-plan des références avant la génération.